Tổng quan
Dự án Machine Learning tập trung vào bài toán phân loại nấm (ăn được hay có độc) bằng cách huấn luyện và so sánh hiệu năng giữa nhiều thuật toán học máy khác nhau. Toàn bộ quy trình bao gồm tiền xử lý dữ liệu tỉ mỉ, kỹ thuật tạo đặc trưng (feature engineering) và đánh giá mô hình bằng kỹ thuật k-fold cross-validation.
Quy trình xử lý dữ liệu
Chuẩn bị dữ liệu
- Nạp và phân tách tập dữ liệu với định dạng phân cách bằng dấu chấm phẩy.
- Xử lý 21 thuộc tính đặc trưng khác nhau bao gồm:
- Dữ liệu phân loại (Categorical): hình dạng mũ, bề mặt, màu sắc, cấu trúc mang nấm.
- Dữ liệu liên tục (Continuous): kích thước thân nấm, đường kính mũ nấm.
- Biến mục tiêu: nhãn phân loại nấm (edible vs poisonous).
Kỹ thuật tạo đặc trưng (Feature Engineering)
-
Xử lý đặc trưng phân loại:
- Áp dụng One-Hot Encoding cho 17 đặc trưng dạng danh mục.
- Sinh nhãn đặc trưng tự động.
- Chuyển đổi sang định dạng ma trận thưa (sparse matrix) nhằm tối ưu bộ nhớ.
-
Xử lý đặc trưng liên tục:
- Áp dụng Standard Scaling để chuẩn hóa các thuộc tính số học.
- Chuẩn hóa kích thước thân và đường kính mũ nấm về cùng thang đo.
- Ghép nối các đặc trưng tạo thành tập dữ liệu hoàn chỉnh sẵn sàng huấn luyện.
Triển khai mô hình
Đánh giá chéo (Cross-validation)
- Triển khai k-fold cross-validation với $k = 10$.
- Đảm bảo tính nhất quán và khách quan khi so sánh hiệu năng giữa các mô hình.
- Đo lường độ chính xác trung bình và phương sai tin cậy.
Các mô hình được đánh giá
-
K-Nearest Neighbors (KNN)
- Thử nghiệm các giá trị $k$ từ 1 đến 10.
- Đạt hiệu năng tối ưu tại $k = 15$.
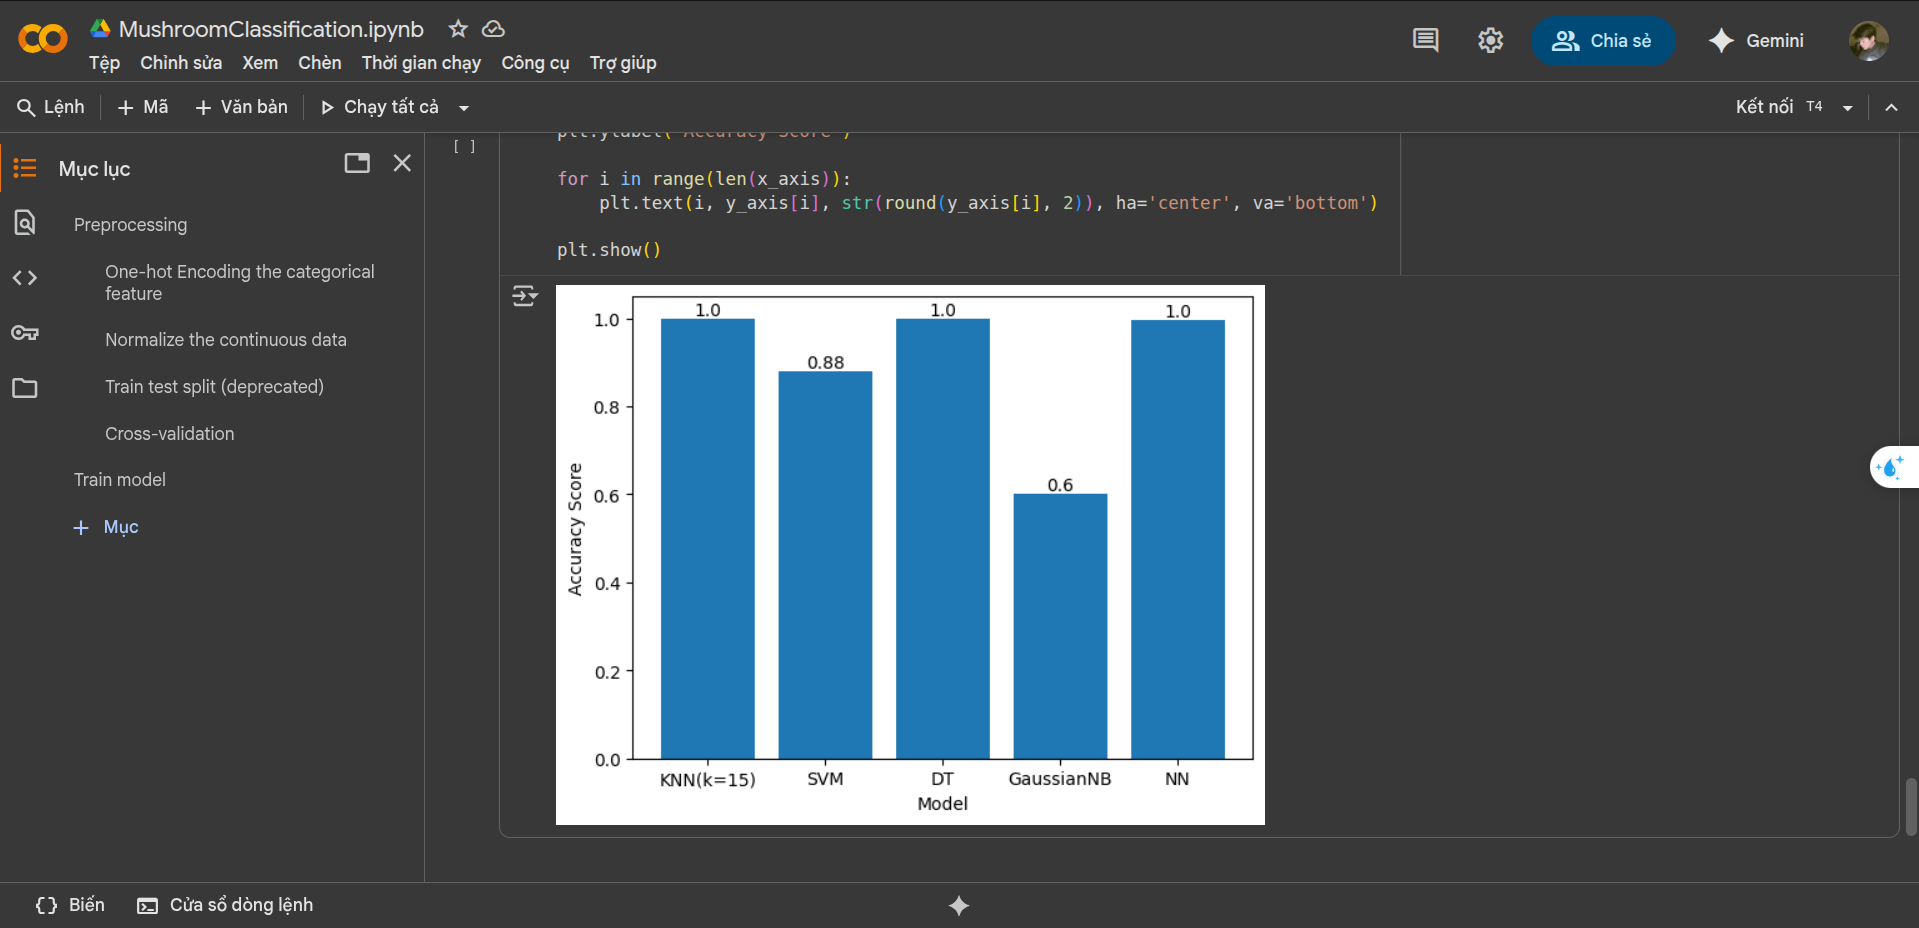
- Độ chính xác (Accuracy): 100%.
-
Support Vector Machine (SVM)
- Sử dụng kernel tuyến tính (Linear kernel).
- Tinh chỉnh siêu tham số $C = 1$.
- Độ chính xác (Accuracy): 88%.
-
Decision Tree (Cây quyết định)
- Cấu hình theo tham số mặc định của Scikit-learn.
- Độ chính xác (Accuracy): 100%.
-
Gaussian Naive Bayes
- Bộ phân loại dựa trên xác suất Bayes.
- Độ chính xác (Accuracy): 60%.
-
Neural Network (Mạng nơ-ron)
- Bộ phân loại Multi-Layer Perceptron (MLP).
- Thiết lập $\alpha = 1$, số vòng lặp tối đa 1000.
- Độ chính xác (Accuracy): 100%.
Phân tích kết quả
So sánh hiệu năng
- Nhóm đạt hiệu năng hoàn hảo (100%): KNN ($k = 15$), Mạng nơ-ron (MLP), Cây quyết định (Decision Tree).
- Nhóm đạt hiệu năng tốt: SVM (88%).
- Nhóm hiệu năng thấp: Gaussian Naive Bayes (60%) do giả định phân phối độc lập gặp khó khăn với không gian đặc trưng phức tạp.
Công nghệ sử dụng
- Ngôn ngữ & Thư viện: Python, Pandas, Scikit-learn, NumPy, Matplotlib.
- Nền tảng thực nghiệm: Google Colaboratory.